Le poste de commande

Le produit tel qu'il tourne, pas une maquette.

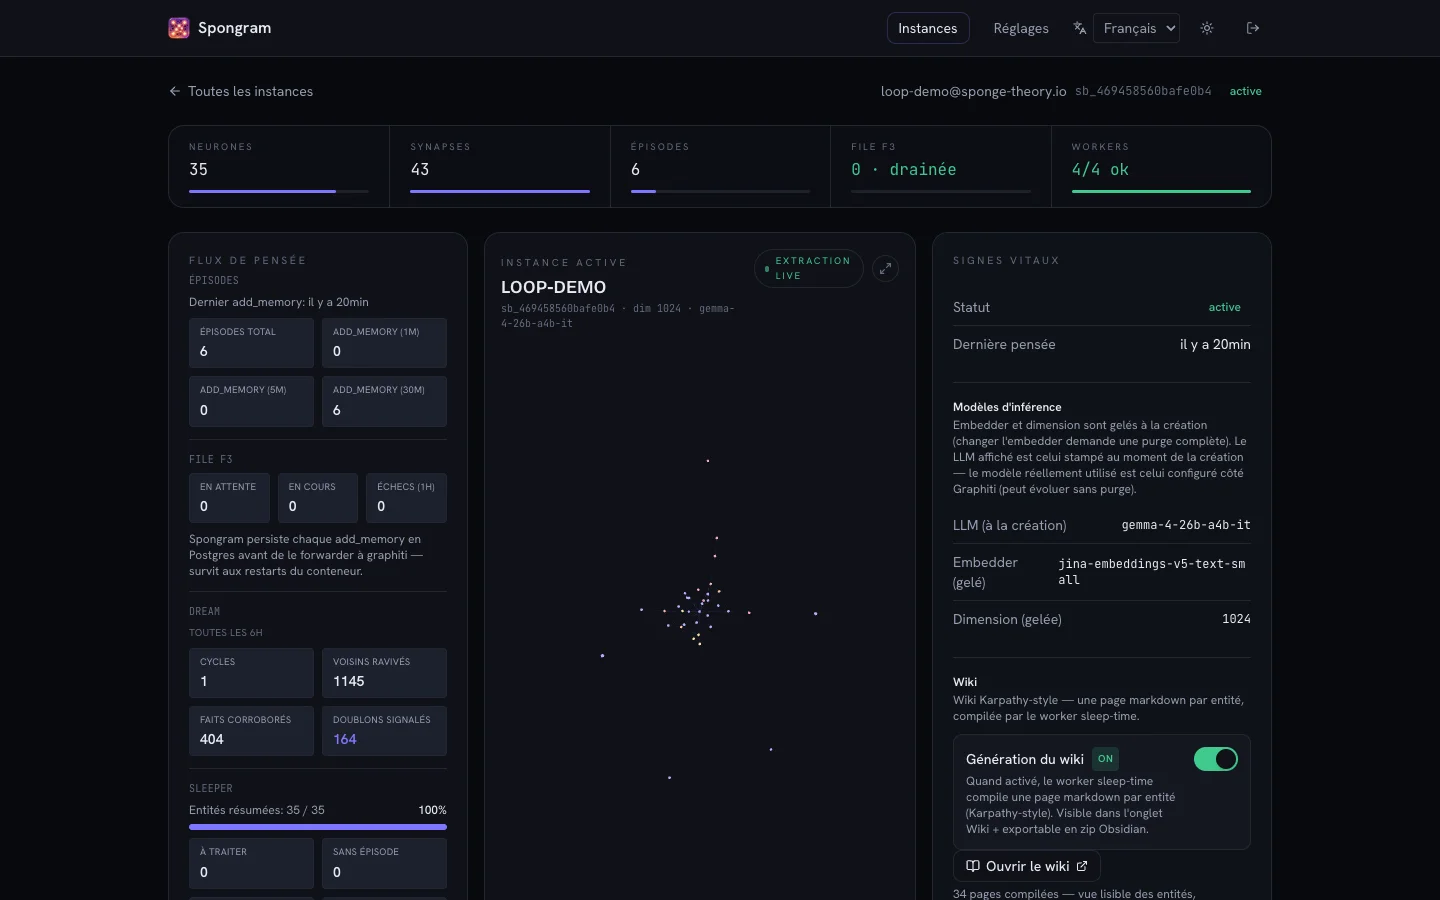
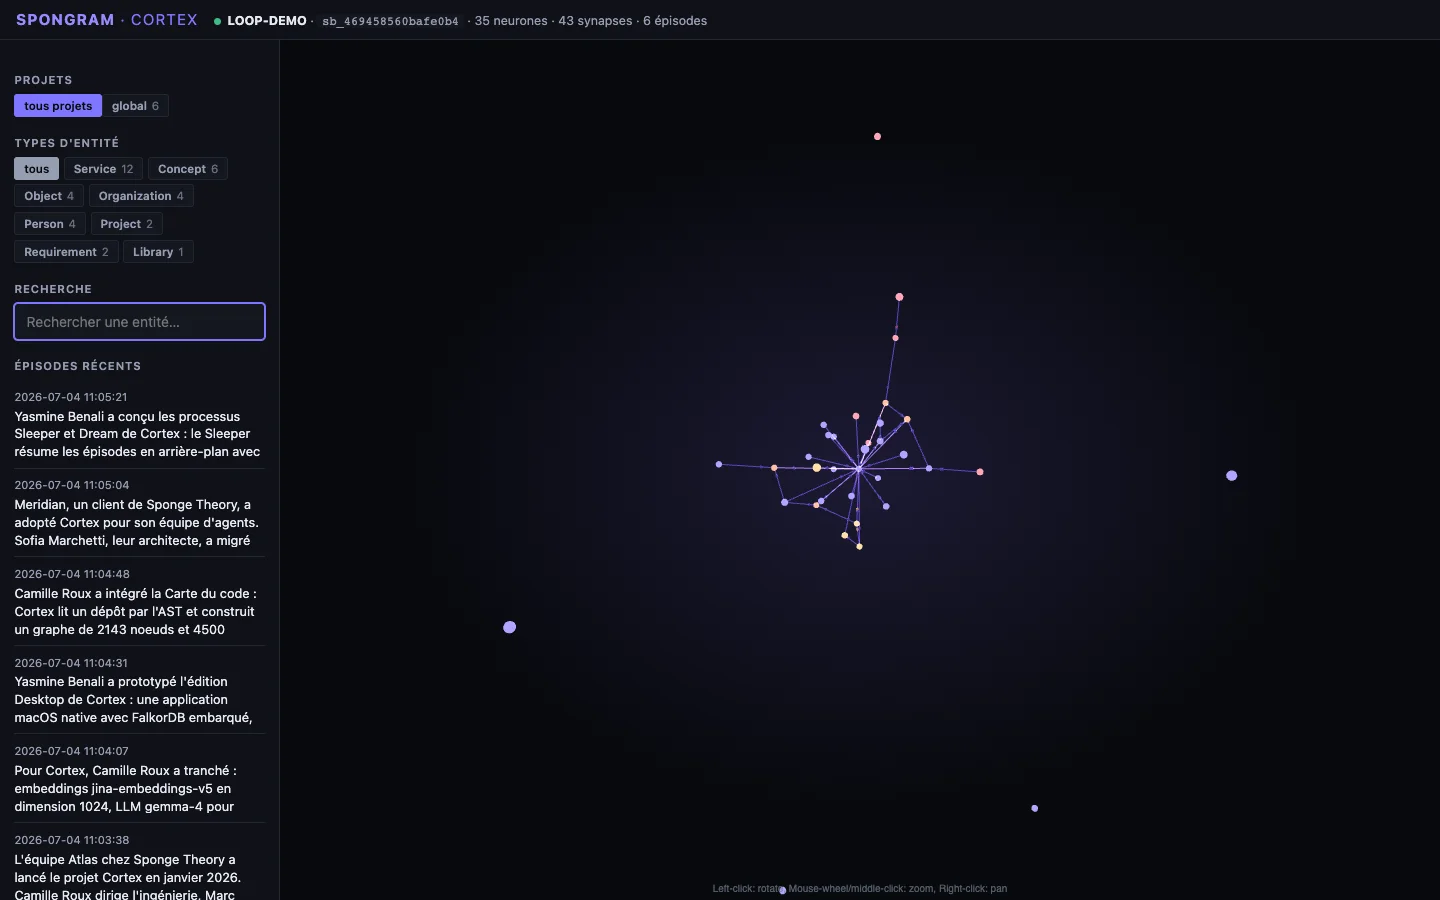
Quatre écrans réels de l'admin cloud en production — dark-first, dôme Cortex vivant, explorateurs plein écran.
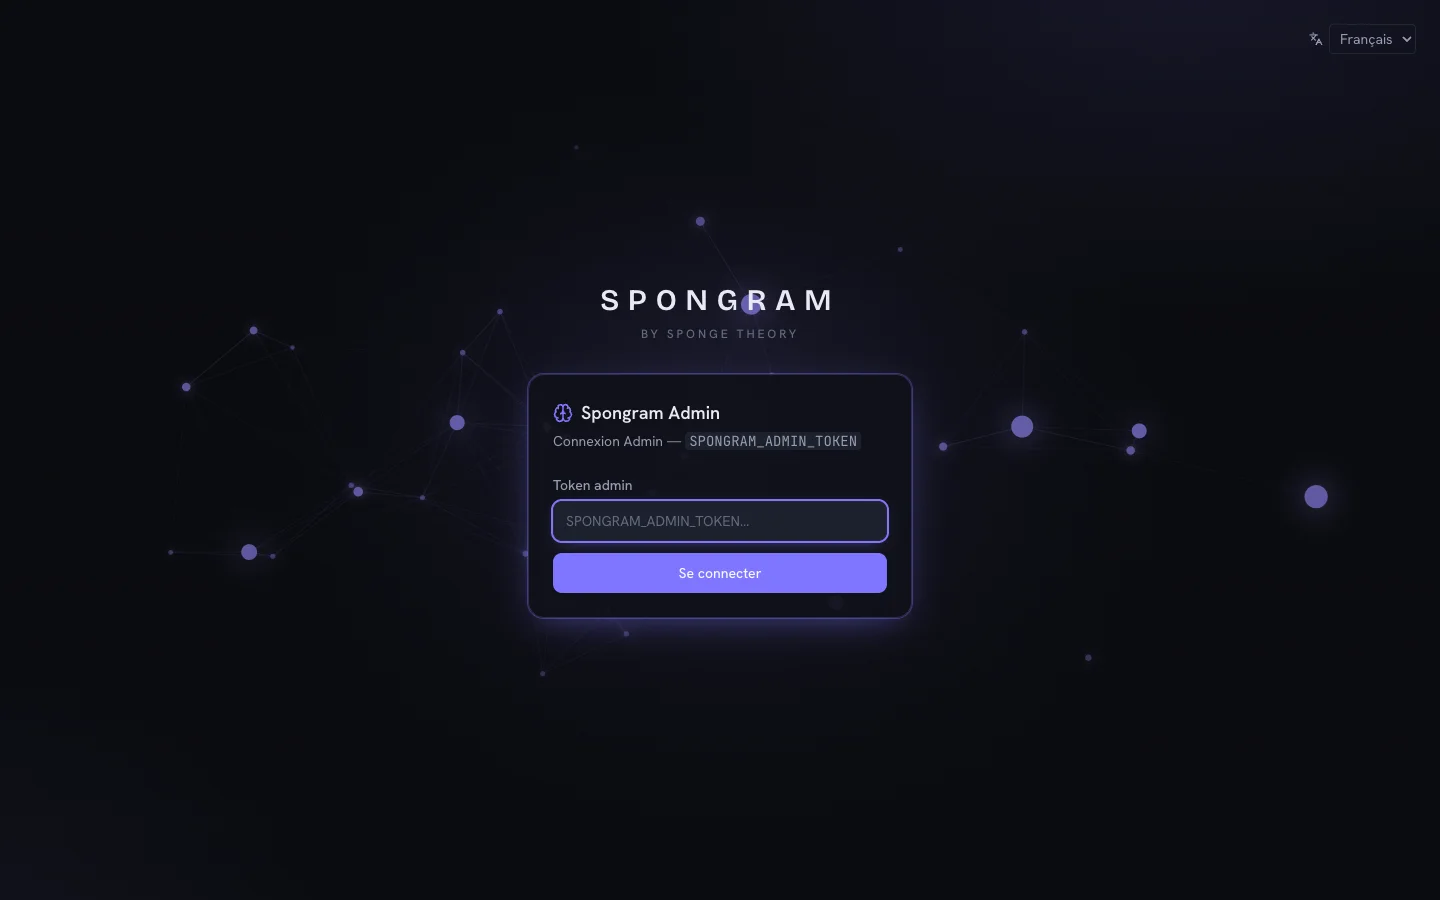
Écran de connexion admin Spongram, thème sombre
Connexion — dark-first, une seule surface visuelle du desktop au cloud.
Liste des instances Spongram dans l'admin
Flotte d'instances — statut, cerveaux isolés par tenant, bundles en un clic.
Dôme Cortex 3D en direct dans l'admin
Le pont + le dôme — Cortex 3D live, SSE, chaque pensée devient un nœud.
Overlay explorateur plein écran du graphe
Explorateur plein écran — graphe, wiki et code map, mêmes tokens visuels partout.

Ce que Spongram fait aujourd'hui

Toutes les capacités listées ici sont vérifiables dans le code livré.

Personas

Personas portables entre Claude Desktop, Claude Code et Codex
Une identité que l'agent adopte quand vous le lui demandez : rôle, voix (ton, tutoiement, langue), intention, règles. Une seule active par cerveau, jamais de cumul, jamais de persona implicite. Elle vit à côté du cerveau, sur votre infra, et vous suit d'un client à l'autre et d'une machine à l'autre.
Compétences au standard ouvert Agent Skills
Chaque persona porte jusqu'à 8 compétences au format SKILL.md (agentskills.io) : collez-les, éditez-les, ou importez-les depuis une URL brute. Divulgation progressive — l'agent ne voit que le nom et la description, et ne charge le corps complet que quand la tâche le demande.
Une mémoire propre à chaque persona
Ce que la persona apprend est tagué à son nom et la suit partout où elle est active, quel que soit le projet. Le tri se fait côté serveur d'après les tags des épisodes : ses souvenirs remontent en tête, le bruit des autres projets est écarté, et le nombre d'écartés vous est rendu pour proposer une recherche élargie.
L'activation reste votre geste
Vous dites « active mon spécialiste marketing » et l'agent adopte le rôle. L'interface crée, édite et affiche l'état actif — elle n'active rien. Claude Code n'est jamais dégradé : il n'hérite par défaut que du ton et de la langue, précédés de la règle que les conventions du projet priment.

Fondations

Self-host on-prem
Stack docker-compose ou Swarm + Portainer. Aucune dépendance cloud externe.
Inférence pluggable & hot-swap
Page admin Settings + dropdown 8 presets + mode Custom + probe 3-layer (chat / tool_calls / json_schema strict). Changement de provider effectif à la requête suivante, sans redémarrer aucun conteneur.
Plugins Claude Code et Codex
Bundle .plugin généré par tenant : marketplace, SKILL.md, hook SessionStart. Adaptateur Codex avec assistant de connexion (URL de l'instance + clé au trousseau) et les mêmes outils MCP.
Édition Desktop native (macOS)
App Tauri signée Developer ID : sidecar Python gelé (PyInstaller), FalkorDB embarqué, 100 % offline. Mémoire, Carte du code, Cortex 3D, Wiki, Recherche, Pulse, Réglages — sans Docker ni base externe. Windows et Linux en préparation.
Licence Lemon Squeezy intégrée (desktop)
Activation de licence dans l'app, validation locale, licence à vie par poste.

Mémoire & multi-tenant

Multi-tenant strict
group_id injecté côté serveur, rejet anti-tampering. Une instance, N cerveaux, zéro fuite croisée.
Faits bi-temporels
valid_at / invalid_at hérités de Graphiti — supersession automatique sur contradiction.
Mémorisation proactive
Les agents (Claude Code, Claude Desktop) déclenchent add_memory tout seuls dès qu'un fait, une préférence ou une décision est énoncé — pas besoin de leur demander. Codex appelle les mêmes outils, sur demande explicite.
Mémoire « globale » cross-projet & cross-client
Un fait tagué project=global (dit dans n'importe quel projet, depuis Claude Desktop ou Codex) est rappelé depuis TOUS vos projets : un seul cerveau partagé entre toutes vos codebases et tous vos clients. Les faits spécifiques restent scopés par projet ; la recherche garde par défaut le projet courant + le global et écarte le bruit des autres projets.
Validation d'autorité à l'ingestion (couche constitutionnelle)
Gate de provenance optionnel au seuil d'add_memory : un épisode doit porter les tags attendus (project=, et client= depuis une allow-list configurée) avant d'entrer dans le cerveau, sinon il est rejeté avant même la file durable. Déterministe, sans dépendance, activable par flag. Répond à la critique classique « stocke n'importe quoi sans valider l'autorité des entités ».
File d'épisodes durable
Chaque add_memory est persisté en Postgres avant d'atteindre Graphiti. Aucune perte au redémarrage du conteneur, retry automatique sur erreur transitoire (écriture via la file, lecture via retry/backoff borné sur le chemin Graphiti). Les épisodes surdimensionnés (>32k tokens) sont auto-découpés avant extraction pour ne jamais être rejetés par le LLM.
Confidence sur les faits
Chaque relation porte un score de confiance qui monte sur corroboration multi-source. Filtrage par seuil exposé via /v1/graph/data.
Oubli granulaire (3 niveaux)
Entité (clic dans le Cortex 3D), fait spécifique (DELETE /forget/fact/{uuid}, GDPR-grade avec audit log), instance entière (DELETE qui purge automatiquement Neo4j et Postgres).

Carte du code

Carte du code (code-map structurelle)
Extraction AST client-side via tree-sitter (~30 langages) : fichiers, classes, fonctions, imports, appels — y compris les appels qualifiés module.attr() inférés par AST. 276 fichiers → 2 143 nœuds / 4 509 arêtes en ~14 s sur le repo Spongram. Graphe portable Neo4j (cloud) et FalkorDB (desktop), isolé par tenant, mis à jour par hook git post-commit.
5 outils MCP code_map_* + onglet 3D dédié
code_map_query / neighbors / god_nodes / shortest_path / stats. Les souvenirs qui citent un fichier ou un symbole remontent automatiquement leurs nœuds de code liés dans search_nodes. Une mini-carte (~110 tokens) est injectée au SessionStart : taille du repo, dossiers, fichiers centraux — l'agent est orienté avant son premier appel d'outil.

Science de fond

Sleep-time compute (Sleeper)
Worker en fond qui synthétise les Summary nodes et les pages Wiki, en concurrence bornée (plusieurs entités en parallèle, cap configurable via SPONGRAM_SLEEPER_CONCURRENCY). Idempotent : ré-exécute uniquement les entités dont l'ensemble d'épisodes a réellement changé (hash sha256). Activable par flag (désactivé par défaut).
Dream cycle (consolidation périodique)
Détection des doublons par similarité cosine, décroissance temporelle des edges (courbe d'Ebbinghaus exp(-Δt/τ)), propagation des communautés (LPA), boost sur corroboration multi-source. Activable par flag (désactivé par défaut).
Résolution de doublons non-destructive + co-évolution (A-MEM)
Le Dream relie les entités de même nom normalisé par un edge :SAME_AS — sans fusion, zéro perte de données : recall et UI les traitent comme une seule. Les alias co-évoluent (pattern A-MEM, NeurIPS 2025) : quand l'un porte un résumé plus frais, l'autre est re-synthétisé au tick suivant au lieu de diverger.
Score d'importance à l'ingestion
Chaque entité reçoit un score 1-10 calculé sur le nombre de sources et la densité de connexions (formule log-base). Sert de 3e axe de retrieval (cosine + récence + importance) via reciprocal rank fusion.
Recherche multi-hop par PageRank personnalisé
Personalized PageRank style HippoRAG sur le sous-graphe à 2-hops des top-K cosine, fusion par reciprocal rank. Observable (métriques Prometheus rerank / fallback par raison / latence), timeout sous-graphe accordé pour que le rerank tourne vraiment au lieu de retomber silencieusement. Activable par flag, prêt pour A/B mesuré.
Cache chaud sur la recherche
LRU + TTL au-dessus de search_nodes / search_memory_facts, scopé par tenant. Recall répété servi en quelques millisecondes (mesuré en local), invalidation immédiate à l'écriture (y compris via la file d'ingestion), hit-rate exposé en Prometheus. Activable par flag (pattern Memory³).
Mémoire procédurale (skills)
Namespace :Skill séparé des faits. MCP tools record_skill / recall_skill — recall scoré name > intent > body, isolation multi-tenant stricte.
Réflexion sur les échecs
MCP tool reflect_on_failure : capture verbale d'un échec (intent + lesson) transcodée en épisode tagué failure_pattern avec importance boostée. Pattern Reflexion (Shinn et al. 2023) sans weight update.

Wiki & Cortex 3D

Wiki block-by-block (style Karpathy)
Page Markdown déterministe par entité : header, résumé Sleeper, sources, liens [[wiki]]. Seul le résumé vient du LLM, le reste est rendu par Python pur — versionné, exportable en ZIP Obsidian.
Communautés et thèmes
LPA en Cypher pur sur le graphe Neo4j (zéro plugin GDS), endpoint /v1/wiki/themes.json. Chaque communauté reçoit un label déterministe (membres clés par importance, sans LLM donc sans hallucination), généré par le Dream après détection, puis roulé en un digest niveau-tenant (abstraction hiérarchique au-dessus des communautés). Le Wiki et l'admin rendent une section « Thèmes » nommée par tenant.
UI Cortex 3D incluse
Explorateur de graphe rendu via 3d-force-graph (zéro pipeline bundler). SSE live updates, filtres par projet, suppression d'entité à la souris, pagination serveur pour explorer les grands graphes par fenêtres.

Hardening prod

Admin web complète
Settings inference, instances, activité par tenant, ledger d'usage 90 jours, téléchargement de bundles, gestion des tokens et marketplace. Authentification SPONGRAM_ADMIN_TOKEN.
Hardening production
/healthz multi-composant (Postgres, Neo4j, Graphiti, 3 workers), /metrics Prometheus, circuit breakers sur LLM et embedder, audit Postgres ↔ Neo4j, migrations idempotency-checked, endpoint /orphans/{gid}/purge pour rattrapage.
Rate limiting par instance
100 requêtes/minute par tenant, 429 au-delà (spec §8.4). Protège l'inférence partagée : un tenant bruyant ne peut pas affamer les autres.
Bench recall-quality reproductible
Suite pytest tests/bench/ qui rejoue un sous-ensemble LongMemEval (knowledge_update) avec LLM-as-judge. Le banc attend la vidange réelle de la file ET le plateau d'extraction avant de mesurer (plus de baseline tronquée). Rapport précision / latence p50-p95 / tokens, baseline figée en JSON, comparaison ON / OFF des features de retrieval.

i18n intégral

Produit entièrement bilingue
Admin (300+ clés), desktop (140+ clés), landing et surfaces serveur (/v1/graph, /v1/wiki, /v1/codemap via ?lang=) — FR/EN de bout en bout, parité vérifiée clé par clé à chaque lot.

D'autres produits couvrent ce terrain — comparez par vous-même :

Personas : une identité, ses compétences, sa mémoire

Les Styles de Claude.ai, les output styles de Claude Code et les modes de Roo Code existent — aucun n'est portable d'un client à l'autre, ni relié à une mémoire. Une persona Spongram l'est.

Une seule active par cerveau
Garanti en base par un index unique partiel, pas par une convention : deux personas actives sont impossibles. Sans persona active, rien n'est injecté — le chemin est identique à celui d'avant, octet pour octet. Aucune persona par défaut implicite.
Activation par l'agent uniquement
L'outil MCP activate_persona est le seul chemin. Il n'existe aucune route HTTP d'activation, volontairement : l'interface crée et édite, l'agent adopte. Une activation renvoie le bloc complet à adopter, et remplace la persona précédente en une transaction.
Compétences au standard Agent Skills
Le SKILL.md complet est stocké tel quel, frontmatter compris ; name et description sont validés à l'entrée. Import depuis une URL https uniquement, redirections https→https bornées, corps plafonné à 32 Ko, jamais d'exécution. 50 compétences par cerveau, 8 par persona.
Mémoire par persona en « lentille »
Un seul graphe, pas de sous-graphe : les épisodes de la persona portent son tag, posé et validé côté serveur. Un tag qui ne correspond pas à la persona active est retiré, comme le group_id — même esprit anti-falsification. Aucun épisode existant n'est re-tagué ni déplacé.
Filtrage de lecture sans perte silencieuse
Les résultats de recherche sont triés d'après les tags de leurs épisodes sources, en une requête indexée. Les souvenirs de la persona active remontent en tête, les autres projets sont écartés — et le nombre d'écartés est renvoyé dans la réponse, pour que l'agent puisse vous proposer d'élargir.
Claude Code n'est jamais dégradé
Jamais d'output style, jamais de modification du system prompt, de CLAUDE.md, des permissions ou de la liste d'outils. L'injection est additive et rejouée après compaction. Par défaut Claude Code n'hérite que de la voix, précédée du rappel que les instructions de développement priment.
Cartes de personas exportables
Export et import au format ouvert Character Card V2 (chara_card_v2), corps JSON seulement : aucune image, aucune URL récupérée par le serveur. Une persona importée arrive toujours inactive — l'activation reste votre geste.
Un résumé « ce que je sais déjà »
Le worker de fond compile pour chaque persona un résumé de ses propres épisodes, borné à 120 mots, et le joint au bloc à l'activation. Idempotent : il n'est recalculé que si le jeu d'épisodes a réellement changé.

La carte du code : moins de tokens, meilleures réponses

Spongram cartographie vos repos par AST (tree-sitter) et expose le graphe à Claude Code via 5 outils MCP. Tout ce qui suit est mesuré en sessions claude -p réelles, sur le repo de Spongram lui-même — protocole et runner livrés avec le produit (docs/BENCH_CODEMAP_2026-06-10.md).

Question de navigation de codeSans Spongram (grep/read)Avec Spongram (code-map)Δ coût
Fichiers / symboles les plus centraux $0.329 — sous-agent + 29 greps, classement estimé $0.105 — 1 appel god_nodes, degré exact du graphe −68 %
Vue d'ensemble d'un package $0.291 $0.178 −39 %
Qui appelle cette fonction ? $0.086 $0.106 — appelants prod + tests en 1 appel +23 %*
Contenu d'un module (classes, méthodes) $0.128 $0.181 +41 %*
Chemin de dépendance A → B $0.107 $0.129 +20 %*
Total (6 questions) $1.05 $0.83 −21 %
Temps de réponse cumulé 293 s 151 s −48 %

* Sur le ponctuel, grep reste moins cher — et c'est exactement ce que la SKILL livrée dit à l'agent : chaque outil à sa place. Banc A/B en sessions claude -p réelles (Sonnet), 1 question par session, outils en lecture seule, repo de 276 fichiers ; total entre −12 % et −21 % selon les runs.

Extraction AST déterministe, zéro LLM

tree-sitter côté client (~30 langages) : 276 fichiers → 2 143 nœuds / 4 509 arêtes en ~14 s. Aucun coût d'indexation, résultat reproductible au commit près.

5 outils MCP dédiés

code_map_query, neighbors, god_nodes, shortest_path, stats — y compris les appels qualifiés module.attr() inférés par AST, que grep rate souvent.

Mini-carte au SessionStart

~110 tokens injectés à l'ouverture : taille du repo, dossiers, fichiers centraux. L'agent est orienté avant son premier appel d'outil.

Mémoire et code reliés

Un souvenir qui cite un fichier ou un symbole remonte automatiquement ses nœuds de code dans search_nodes. La carte reste fraîche via le hook git post-commit.

Dans les deux éditions

Onglet 3D « Carte du code » ; graphe portable Neo4j (cloud) / FalkorDB embarqué (desktop), isolé par tenant.

Choisissez votre inférence

Spongram parle OpenAI-compat. 8 presets, plus un mode Custom pour n'importe quel endpoint. Changement à chaud depuis l'admin, validation 3-layer intégrée.

hosted
SPT Models
Stack hébergée Sponge Theory (défaut)
local
Ollama
Workstation locale, port 11434
local
LM Studio
Desktop Mac/Win, port 1234
local
vLLM
GPU server NVIDIA, port 8000
cloud
OpenAI
Cloud, gpt-4.1 family
cloud
Anthropic Claude
Cloud via LiteLLM adapter
cloud
Mistral
Cloud, mistral-large
cloud
Groq
Cloud, llama-3.3 sub-second

Tous gérés par la même page admin Settings. Bouton « Tester la connexion » → 3-layer probe (chat / tool_calls / json_schema strict) → vous savez en 3 secondes si votre provider est Graphiti-compatible.

L'architecture en une diapositive

Une seule instance FastAPI sert le MCP, l'admin, l'explorateur 3D et la landing. Le reste est du Postgres et du Neo4j, hébergés côte à côte.

Claude Code Claude Desktop Codex MCP client Spongram auth + group_id /mcp /admin/api /v1/graph (cortex) SPT Models LLM (Qwen/Gemma) jina-embeddings-v5 Graphiti bi-temporal extraction Postgres instances episodes Neo4j nodes edges Sleeper background Summary + Wiki
  • Client (Claude Code, Claude Desktop, Codex) → MCP HTTP → Spongram (auth Bearer spt_brain_*)
  • Spongram injecte `group_id`, route vers Graphiti, rejette toute tentative de tampering
  • Graphiti écrit dans Neo4j (graphe) et Postgres (épisodes/instances), interroge SPT Models pour LLM + embeddings
  • Sleeper (activable par flag) boucle en fond pour générer Summary nodes et pages Wiki déterministes

Installation, version courte

À l'achat, vous recevez les images Docker et le template d'environnement. Trois étapes, 10 minutes sur une machine avec Docker.

  1. 01

    Configurer l'environnement

    cp .env.example .env
    # ajustez SPONGRAM_ADMIN_TOKEN + SPONGRAM_INFERENCE_API_KEY
    # pointez SPONGRAM_INFERENCE_BASE_URL sur votre endpoint OpenAI-compat
  2. 02

    Lancer la stack

    docker compose up -d
    # Postgres + Neo4j + Spongram démarrent ;
    # migrations SQL appliquées automatiquement
  3. 03

    Créer un cerveau puis brancher votre client

    # Espace admin : http://localhost:8091/admin/
    # créez une instance, copiez la clé spt_brain_ (affichée une seule fois)
    claude plugin marketplace add ezeeFlop/claude-plugins
    claude plugin install spongram@sponge-theory
    # à l'activation : URL de l'instance + clé spt_brain_ (stockée au trousseau)
    # Codex : installez le plugin spongram-codex depuis le même dépôt, puis lancez spongram-setup

Pour la prod : Docker Swarm derrière Traefik, déploiement via Portainer. Documentation complète livrée à l'achat.